Mời bạn thưởng thức Newsletter #68. Bài viết này được thực hiện bởi Claude Code, Claude Code Router, iFlow Open Platform & GLM-4.6 (Bài này mình config CCR dùng nhiều models trên iFlow Platform)
Conscious Debugging: 10 Chiến lược Hiệu quả Thực sự Hoạt động 🐛
Petar Ivanov cho rằng gỡ lỗi (debugging) không phải chuyện may rủi mà là một kỹ năng có thể rèn luyện, và làm chủ nó giúp tiết kiệm thời gian, công sức, tiền bạc lẫn bớt căng thẳng. Bài viết chia 10 chiến lược thành ba nhóm. Nhóm đầu tiên là chuẩn bị nền tảng: tái hiện lỗi một cách nhất quán bằng các bước cụ thể, rút ngắn thời gian tái hiện để thử được nhiều giả thuyết hơn, và thu thập đầy đủ ngữ cảnh từ nhật ký (log), bản ghi phiên làm việc hay phản hồi của người dùng trước khi lao vào đọc mã nguồn. Với kiến trúc microservice, việc vẽ ra luồng đi của một yêu cầu qua các dịch vụ giúp bạn có hình dung rõ ràng về hệ thống.
Nhóm thứ hai là các kỹ thuật gỡ lỗi chủ động: khoanh vùng vấn đề theo kiểu tìm kiếm nhị phân (tạm vô hiệu một nửa đoạn mã nghi ngờ để xem lỗi còn xuất hiện không), tận dụng trình gỡ lỗi để đặt điểm dừng và quan sát biến, giải thích mã nguồn từng dòng cho “chú vịt cao su” hoặc đồng nghiệp, và làm việc như một nhà khoa học: đặt giả thuyết, thử nghiệm, quan sát, sửa rồi xác minh. Khi bế tắc, hãy ghi lại những gì đã thử, nghỉ giải lao có chủ đích, và dùng AI một cách thông minh bằng cách cung cấp đủ ngữ cảnh — AI không phải phép màu, nhưng là trợ thủ đáng giá khi có thông tin đầy đủ.
The fate of “small” open source
Nolan Lawson nhìn lại blob-util, thư viện npm nhỏ anh viết cách đây khoảng 10 năm và vẫn có hơn 5 triệu lượt tải mỗi tuần. Khi khoảng 80% lập trình viên đã dùng AI trong công việc, những tiện ích kiểu này có thể được LLM sinh ra ngay theo yêu cầu — anh thử nhờ Claude viết hàm chuyển Blob sang ArrayBuffer và nhận được kết quả gần giống phiên bản của mình. Nhiều người coi đó là tiến bộ: ít phụ thuộc hơn, tránh được rủi ro về hiệu năng, bảo trì và chuỗi cung ứng. Nhưng tác giả cho rằng có thứ đã mất đi: blob-util được viết với tinh thần của người thầy, kèm hướng dẫn giúp người dùng hiểu cách làm việc hiệu quả với JavaScript. Khi ta đề cao câu trả lời tức thì hơn việc học và hiểu, động lực để viết thư viện và giảng giải về vấn đề cũng giảm theo.
Kết luận của anh: thời của các thư viện nhỏ, giá trị thấp đã qua — vốn đã thoái trào vì Node.js và trình duyệt dần tích hợp sẵn tính năng, và LLM là “chiếc đinh cuối cùng đóng vào quan tài”. Dù vậy, mã nguồn mở vẫn còn chỗ đứng ở những dự án lớn hơn, sáng tạo hơn, hoặc thuộc lĩnh vực ngách chưa có trong dữ liệu huấn luyện của LLM, như công cụ săn rò rỉ bộ nhớ fuite của anh hay framework Ripple.js của Dominic Gannaway — những thứ đòi hỏi nghiên cứu mới và kỹ thuật sáng tạo.
Ngôn ngữ lập trình trong kỷ nguyên AI Agent
Alexandru Nedelcu đặt câu hỏi: khi AI Agent viết mã, lựa chọn ngôn ngữ lập trình còn quan trọng không, hay mọi người sẽ dồn về vài ngôn ngữ phổ biến nhất vì AI được huấn luyện nhiều trên chúng? Anh thừa nhận vòng lặp này có thật — Python phổ biến nên AI viết Python tốt, càng khiến Python phổ biến hơn — nhưng đưa ra hai lý do để lạc quan. Thứ nhất, trình biên dịch với hệ thống kiểu tĩnh giàu biểu đạt (Scala, Haskell, Rust) cho AI phản hồi nhanh hơn cả kiểm thử đơn vị, giúp nó lặp lại và hội tụ về lời giải đúng, hạn chế “ảo giác”. Ví dụ, AI vẫn viết được macro Scala 3 dù có rất ít mã mẫu công khai, nhờ liên tục sửa theo lỗi biên dịch.
Thứ hai, con người vẫn phải xem xét và hiểu được mã do AI tạo ra, vì chỉ chạy thử rồi nhìn kết quả là cách kiểm tra quá hời hợt. Tác giả cảnh báo về “món nợ thấu hiểu” (comprehension debt) — khi không còn ai trong nhóm hiểu cách hệ thống vận hành — và dẫn lời Peter Naur rằng lập trình là quá trình người làm xây dựng một “lý thuyết” về vấn đề. Vì mã nguồn mãi là nguồn sự thật, mã tốt cần thể hiện rõ ý định thiết kế và các bất biến; ngôn ngữ bậc cao giúp đặc tả không bị mất mát. Lập luận suy diễn và “lập luận phương trình” của lập trình hàm vì thế càng có giá trị khi làm việc cùng AI.
“Numbers Everyone Should Know” – Hiểu Biết Cốt Lõi Về Hiệu Năng Hệ Thống
Trang này tổng hợp bảng “những con số ai cũng nên biết” của Jeff Dean (Google) — độ trễ tham chiếu của các thao tác cơ bản trong máy tính. Truy cập bộ nhớ đệm L1 mất khoảng 0,5 ns, L2 khoảng 7 ns, dự đoán nhánh sai 5 ns, khóa/mở mutex và truy cập bộ nhớ chính đều khoảng 100 ns. Nén 1 KB bằng Zippy hay gửi 1 KB qua mạng 1 Gbps tốn cỡ 10.000 ns (0,01 ms); đọc tuần tự 1 MB từ bộ nhớ mất 0,25 ms, trong khi một vòng đi-về trong cùng trung tâm dữ liệu là 0,5 ms. Một lần dịch chuyển đầu đọc ổ đĩa (disk seek) mất 10 ms, đọc tuần tự 1 MB từ đĩa mất 30 ms, còn gửi một gói tin từ California sang Hà Lan rồi quay về mất 150 ms.
Giá trị của bảng nằm ở thứ bậc độ lớn giữa các thao tác hơn là con số tuyệt đối: bộ nhớ chính chậm hơn L1 khoảng 200 lần, còn một lần disk seek chậm hơn L1 tới hàng chục triệu lần. Với lập trình viên trẻ, nắm được các khoảng cách này giúp ước lượng nhanh hiệu năng ngay từ khi thiết kế, hiểu vì sao cần tận dụng bộ nhớ đệm và giảm thao tác vào/ra không cần thiết, đồng thời tránh những “cái bẫy hiệu năng” phổ biến khi xây dựng hệ thống phân tán hay xử lý dữ liệu lớn.
The Internet is Cool. Thank you, TCP
Moncef Abboud giải thích vì sao TCP là “con ngựa thồ” của Internet, nền tảng cho HTTP, SMTP hay SSH. Mạng vốn không đáng tin cậy: gói tin có thể mất, hỏng, trùng lặp hoặc đến sai thứ tự. IP chỉ đưa gói tin tới đúng máy, còn tầng giao vận dùng cổng (port) để giao tới đúng tiến trình — giống địa chỉ tòa nhà và số căn hộ. TCP lo việc truyền lại, kiểm tra tổng (checksum) cùng nhiều cơ chế khác ngay tại hai đầu kết nối, để bộ định tuyến ở giữa luôn đơn giản và lập trình viên không phải tự xử lý. Bên cạnh đó, cơ chế kiểm soát luồng (trường window) cho bên gửi biết bộ đệm nhận còn chứa được bao nhiêu, còn cơ chế kiểm soát tắc nghẽn ra đời sau sự cố “sụp đổ do tắc nghẽn” năm 1986, khi băng thông Internet tụt xuống chỉ còn 40 bit/giây.
Phần thực hành dùng C để viết một máy chủ TCP gửi lại những gì client gửi tới, rồi một máy chủ HTTP “giả” đủ để đánh lừa curl, qua đó minh họa các hàm socket kiểu Berkeley như socket, bind, listen, accept, send, recv. Tác giả cũng phân tích cấu trúc segment TCP: mỗi kết nối được định danh bởi bộ 5 giá trị (giao thức, IP và cổng nguồn, IP và cổng đích), bắt tay ba bước SYN → SYN-ACK → ACK để thiết lập, cờ FIN hoặc RST để đóng, và cách số thứ tự (sequence number) cùng số xác nhận (acknowledgment number) giữ cho dữ liệu toàn vẹn, đúng trình tự.
Những hiểu lầm phổ biến của lập trình viên về CPU Caches
Tác giả, người từng làm về bộ nhớ đệm ở Intel và Sun, vạch trần một hiểu lầm phổ biến: rằng lập trình đồng thời khó vì “mỗi nhân CPU có thể giữ giá trị khác nhau, đã lỗi thời trong bộ nhớ đệm riêng”, và từ khóa volatile trong Java tồn tại để buộc đọc/ghi thẳng xuống bộ nhớ chính. Thực tế, bộ nhớ đệm trên các CPU x86 hiện đại luôn được phần cứng giữ đồng bộ nhờ các giao thức nhất quán (cache coherency) như MESI, trong đó mỗi dòng dữ liệu mang một trạng thái Modified, Exclusive, Shared hoặc Invalid. Nếu volatile thật sự phải đi xuống RAM mỗi lần thì nó sẽ chậm hơn khoảng 200 lần; trên thực tế, một lần đọc volatile có thể rẻ ngang một lần truy cập L1.
Vậy vì sao vẫn cần volatile và atomic? Vì dữ liệu nằm trong thanh ghi CPU không được đồng bộ, và trình biên dịch có thể giữ giá trị trong thanh ghi hay sắp xếp lại lệnh với giả định chương trình chạy đơn luồng. volatile buộc thao tác bỏ qua thanh ghi và đi thẳng vào bộ nhớ đệm, nơi giao thức phần cứng bảo đảm mọi luồng thấy cùng một giá trị. Hiểu sai điều này có thể dẫn tới thiết kế tồi, chẳng hạn tin rằng hệ thống đơn nhân miễn nhiễm với lỗi tranh chấp (race condition). Tác giả cũng cho rằng các nguyên lý nhất quán bộ nhớ đệm áp dụng trực tiếp vào hệ thống phân tán và mức cô lập của cơ sở dữ liệu.
Why NaN !== NaN in JavaScript (and the IEEE 754 story behind it)
Trong JavaScript, typeof NaN trả về "number", và mọi phép toán với NaN — cộng, trừ, Math.max — đều cho ra NaN. Lần theo mã nguồn của Firefox và V8, tác giả thấy cả hai đều dùng std::isnan của thư viện chuẩn C++, gợi ý rằng NaN không phải do JavaScript tự nghĩ ra mà đến từ chuẩn số thực dấu phẩy động IEEE 754 năm 1985. Viết lại ví dụ bằng C cho kết quả y hệt: x != x đúng khi x là NaN; xem mã hợp ngữ thì phép so sánh do chính CPU thực hiện qua lệnh ucomisd trên x86. Nói cách khác, NaN !== NaN là hành vi có chủ đích ở cấp phần cứng, không phải lỗi của ngôn ngữ.
Trước IEEE 754, mỗi nhà sản xuất phần cứng xử lý lỗi số học theo cách riêng, thường khiến phép tính như 0/0 làm chương trình dừng đột ngột và gây khó khăn lớn khi mang mã sang nền tảng khác — hãy tưởng tượng điều đó xảy ra trong hệ thống điều khiển máy bay. NaN giải quyết bằng cách “lan truyền” qua chuỗi tính toán, để lập trình viên kiểm tra lỗi một lần ở cuối thay vì sau từng bước. Cách đáng tin cậy để phát hiện giá trị này là dùng Number.isNaN() hoặc kiểm tra x !== x.
Hướng tới lưu lượng QUIC liên hành tinh
Adolfo Ochagavía kể về dự án tư vấn nhằm chứng minh QUIC — giao thức truyền tin cậy thường dùng thay cho TCP — có thể vận hành trong không gian sâu, ví dụ liên lạc giữa Trái Đất và tàu tự hành trên Sao Hỏa. Thử thách rất lớn: tín hiệu mất từ 3 đến 23 phút mỗi chiều, và kết nối bị gián đoạn thường xuyên vì phải chuyển tiếp qua vệ tinh quay quanh hành tinh. Với cấu hình mặc định, QUIC sẽ hết thời gian chờ trước khi kịp thiết lập kết nối. Nhưng vấn đề nằm ở cấu hình vốn thiết kế cho Internet trên mặt đất chứ không ở giao thức: QUIC cho phép tinh chỉnh sâu các tham số như ước lượng thời gian vòng đi-về ban đầu, thời gian chờ khi không hoạt động hay thuật toán kiểm soát tắc nghẽn, còn TCP đã bị đánh giá là không phù hợp.
Việc thử nghiệm trên mạng máy ảo mô phỏng độ trễ thật rất chậm, vì vòng đi-về tới Sao Hỏa có thể lên đến 46 phút. Tác giả giải quyết bằng cách chạy cả client lẫn server trong cùng một tiến trình, giao tiếp qua mạng mô phỏng tự viết, và bật tính năng đồng hồ tự nhảy thời gian của Tokio runtime. Nhờ thiết kế mô-đun của Quinn — thư viện QUIC phổ biến nhất cho Rust — mọi thứ ghép lại suôn sẻ: thử nghiệm chạy gần như tức thì, có tính tất định (cùng tham số luôn cho cùng kết quả), và mỗi bên ghi gói tin ra tệp .pcap để phân tích bằng Wireshark. Hiện ảnh từ Sao Hỏa vẫn được truyền bằng giao thức CFDP, nhưng vài năm nữa câu trả lời có thể là QUIC.
Bloom filters: the niche trick behind a 16× faster API
Đội ngũ incident.io chia sẻ cách giảm độ trễ P95 của một API lọc cảnh báo từ 5 giây xuống 0,3 giây. Cảnh báo được lưu trong PostgreSQL, trong đó các thuộc tính tùy biến của khách hàng như “team” hay “feature” nằm trong cột JSONB. Thuật toán cũ lấy từng lô 500 dòng, giải tuần tự hóa JSONB thành struct Go rồi lọc trong bộ nhớ, lặp lại cho tới khi đủ một trang kết quả. Với khách hàng lớn có hàng triệu cảnh báo, việc này buộc hệ thống phải quét và giải mã rất nhiều dữ liệu. Nhóm cân nhắc hai phương án: chỉ mục GIN — lời giải “chuẩn” của Postgres cho jsonb — và bộ lọc Bloom, một cấu trúc dữ liệu xác suất cho biết một phần tử “chắc chắn không có” hoặc “có thể có” trong tập hợp.
Họ chọn Bloom filter vì lo chỉ mục GIN phình to trên đĩa lẫn bộ nhớ và tốn chi phí ghi cao. Giá trị thuộc tính của mỗi cảnh báo được băm vào một chuỗi bit kiểu bit(512), đủ để đạt tỷ lệ dương tính giả khoảng 1%. Khi truy vấn, Postgres chỉ cần phép AND theo bit (bitmap & bitmask == bitmask) để loại nhanh phần lớn các dòng không khớp ngay trong cơ sở dữ liệu. Kết hợp thêm bộ lọc thời gian bắt buộc (mặc định 30 ngày), tận dụng việc ID dạng ULID sắp xếp được theo thời gian, hiệu năng trở nên ổn định kể cả với tổ chức lớn. Bài học rút ra: đôi khi một thủ thuật khoa học máy tính “ngách” lại hiệu quả hơn giải pháp tiêu chuẩn.
Thiết Kế Là Làm Rõ Bản Chất: Tư Duy Hệ Thống Cho Lập Trình Viên
Trong chuỗi bài đăng này, Ryo Lu cho rằng thiết kế không phải chuyện thẩm mỹ như chọn màu hay trau chuốt giao diện, mà là cách nhìn xuyên qua bề mặt để hiểu cấu trúc bên dưới: phân rã một thứ phức tạp thành các thành phần cơ bản, hiểu mối quan hệ giữa chúng rồi tái tổ hợp thành thứ đơn giản và mạnh mẽ hơn. Khi làm Notion, nhóm không cố tạo thêm một ứng dụng ghi chú hay quản lý công việc mà tìm “nguyên tử” của phần mềm: khối (block), cơ sở dữ liệu, góc nhìn (view) và quan hệ. Từ góc nhìn đó, Asana, Linear, Evernote hay Airtable chỉ là những tổ hợp cứng nhắc của cùng các khái niệm nền, còn Notion trao cho người dùng bộ Lego để tự lắp thứ họ cần. Cursor làm điều tương tự ở một tầng khác, xóa bớt rào cản giữa ý định của con người và phần mềm chạy được: bạn mô tả điều mình muốn, AI lo phần phân rã thành mã nguồn.
Tác giả mở rộng: ngôn ngữ, âm nhạc hay DNA đều là tập hữu hạn phần tử kết hợp vô tận. Những bước ngoặt trong lịch sử máy tính không phải tính năng mới mà là các thành phần nguyên thủy (primitive) mới — dòng lệnh, giao diện đồ họa, siêu liên kết, cảm biến trên điện thoại — và AI chính là một primitive như vậy. Với lập trình viên, bài học là tập nhận diện những thành phần cốt lõi của hệ thống, tự hỏi thứ này thực chất là gì và có thể bỏ đi những gì trước khi nó không còn là chính nó.
Những Dấu Hiệu Của Việc Thực Thi Tốt
Yusuf Aytas cho rằng khi thực thi tốt, môi trường làm việc “yên tĩnh” — không chậm chạp hay thụ động, mà mọi thứ trôi chảy, mọi người phối hợp tự nhiên tới mức ta gần như quên mất sự hiện diện của quản lý. Ngược lại, thực thi kém thì ồn ào và đầy tính “anh hùng”: dự án đình trệ, thêm tầng phê duyệt, quy trình dày lên, cập nhật mang tính phòng thủ, số cuộc họp tăng vọt. Theo tác giả, thực thi tốt dựa trên vài nền tảng: định hướng rõ ràng (điều gì quan trọng, đi đâu và vì sao), bối cảnh ổn định, quyền sở hữu minh bạch với một người chịu trách nhiệm trực tiếp, quy trình gọn nhẹ chỉ nhằm giảm bất định, giữ đà và làm lộ vấn đề sớm, niềm tin, nhịp làm việc đều đặn và vòng phản hồi nhanh, trung thực.
Dấu hiệu của thực thi tốt gồm ít “tiếng ồn” vận hành, an toàn tâm lý để mọi người báo vấn đề sớm mà không sợ bị trừng phạt, và quyền tự chủ khi lãnh đạo gỡ vướng mắc thay vì kiểm soát từng chi tiết. Thực thi cũng có thể đo lường: thời gian giao hàng và thông lượng ổn định, phát hành nhỏ và thường xuyên, cảnh báo có ý nghĩa thay vì gây nhiễu, tỷ lệ thay đổi gây lỗi ở mức kiểm soát được. Thông điệp chính: sự yên tĩnh không phải là thiếu hoạt động, mà là dấu hiệu hệ thống không tự chống lại chính nó.
Bonus
Images:
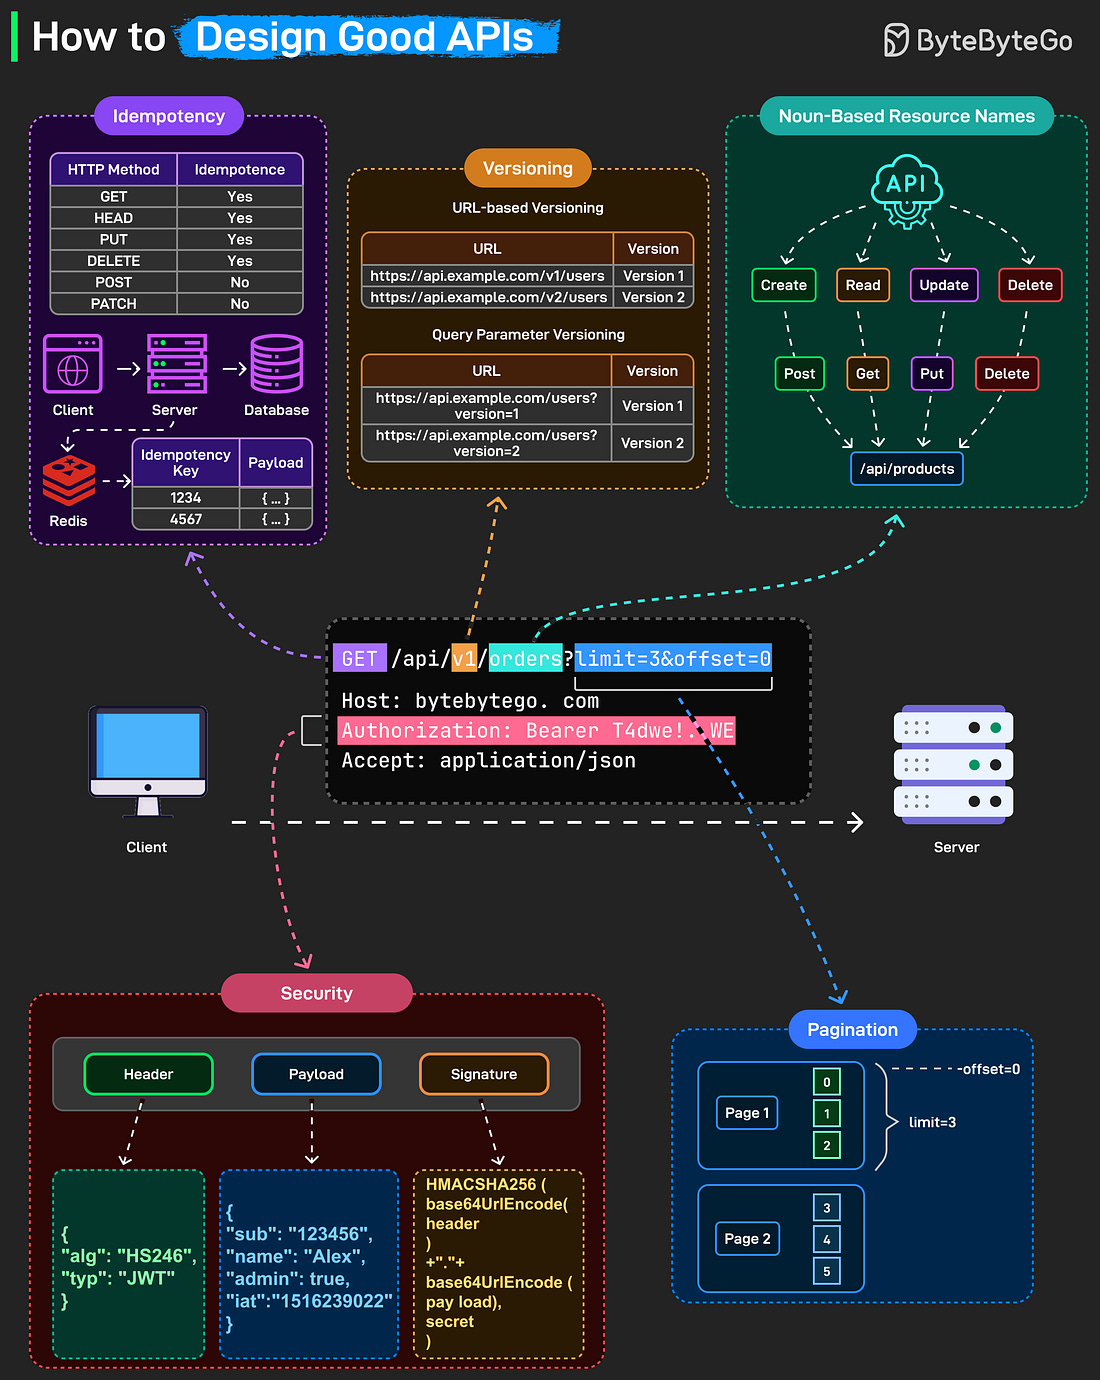
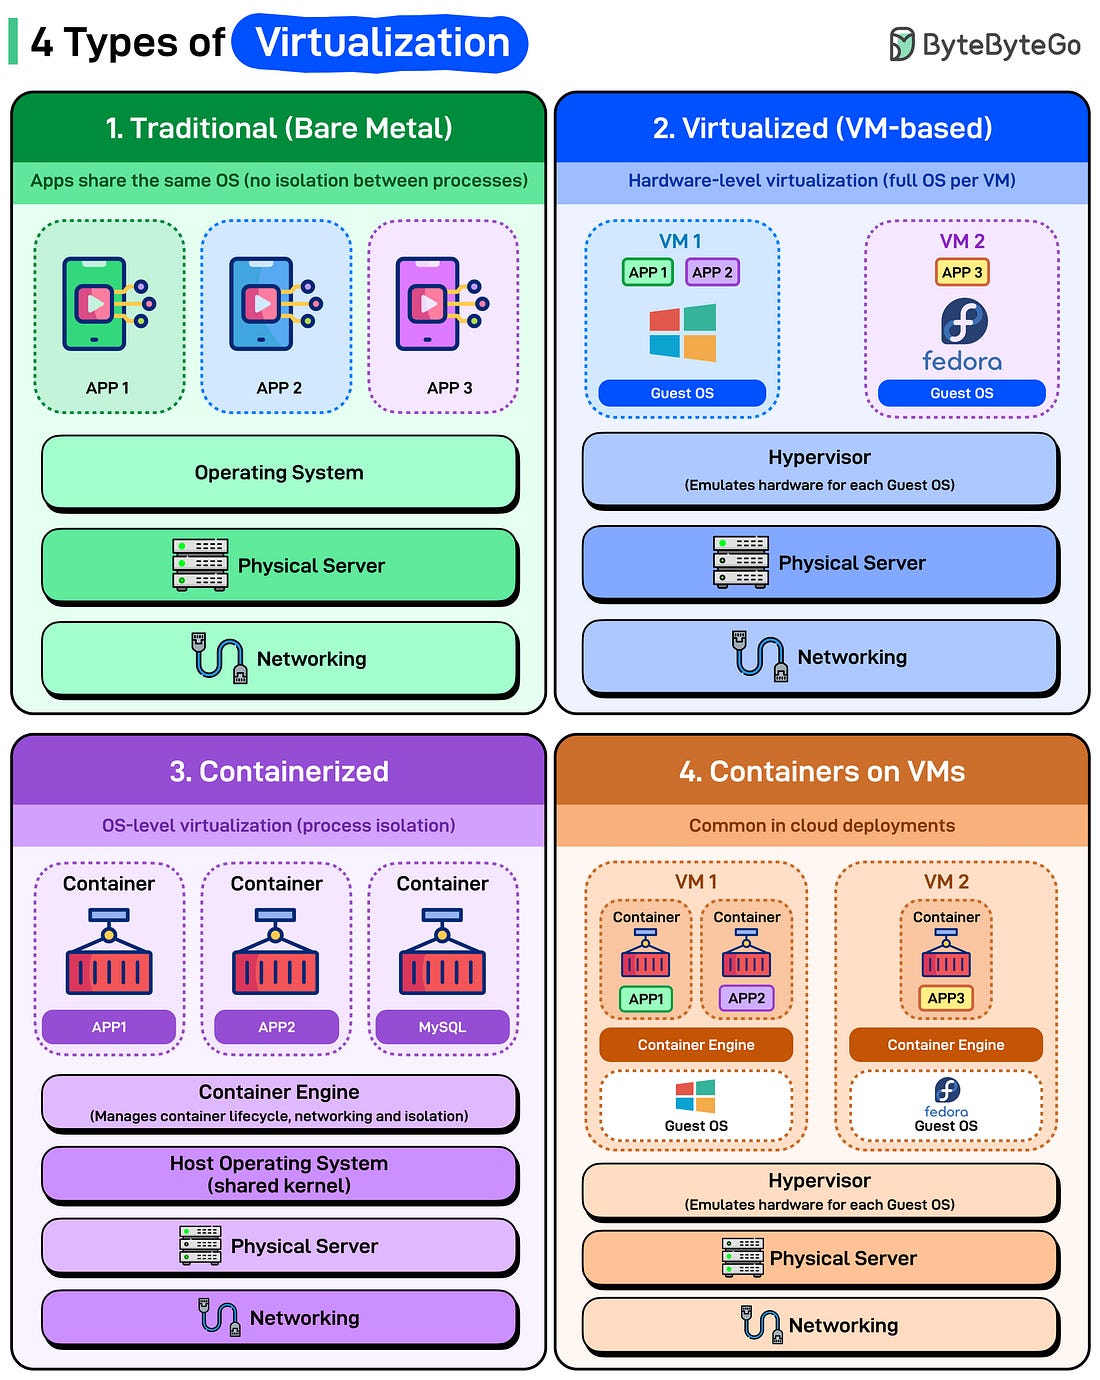
Videos: Why is Kafka Popular?
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.