Mời bạn thưởng thức Newsletter #97.
Why we’re rethinking cache for the AI era
Cloudflare cho biết 32% lưu lượng trên mạng lưới của họ đến từ nguồn tự động, trong đó AI bot đã vượt mốc 10 tỷ request mỗi tuần. Khác với người dùng thật, AI crawler — nhất là các agent lặp nhiều vòng để tinh chỉnh kết quả RAG — có tỷ lệ truy cập URL độc nhất lên tới 70–100%, liên tục lấy nội dung mới thay vì quay lại trang đã xem, quét sâu vào tài liệu, mã nguồn, media và không duy trì phiên làm việc nên mỗi instance bị tính như một khách riêng. Hệ quả là tỷ lệ cache miss tăng vọt, các kỹ thuật tối ưu truyền thống như prefetching mất tác dụng, và người dùng thật chịu thiệt: Wikimedia ghi nhận băng thông multimedia tăng 50%, còn Read the Docs, Fedora hay Diaspora đều bị chậm vì crawler tải lặp lại các file lớn.
Về ngắn hạn, Cloudflare thử nghiệm thay thuật toán thay thế cache LRU bằng SIEVE hoặc S3FIFO — thí nghiệm ban đầu cho thấy người dùng thật có thể giữ nguyên tỷ lệ cache hit dù có lưu lượng AI chen vào — đồng thời phát triển các thuật toán cache dựa trên machine learning, nhận biết từng loại tải. Về dài hạn, họ hướng tới một tầng cache riêng cho AI: người dùng tiếp tục được phục vụ từ edge cache ưu tiên tốc độ, các tác vụ AI nhạy cảm với độ trễ như RAG hay tóm tắt dùng tầng cache trung gian, còn tải thu thập dữ liệu huấn luyện mô hình, vốn chịu được độ trễ cao, được đẩy xuống tầng cache sâu hơn hoặc xếp hàng chờ khi hạ tầng quá tải.
A Behind-the-Scenes Look at How We Release the Spotify App (Part 1)
Spotify kể lại cách đội Release đưa ứng dụng iOS và Android tới hơn 675 triệu người dùng mỗi tuần, với hàng trăm thay đổi trong mỗi bản phát hành. Release Manager vừa điều phối giữa các feature team, vừa xây dựng công cụ cho toàn bộ quy trình phát hành, luôn phải cân bằng giữa tốc độ và chất lượng. Theo hành trình của phiên bản 8.9.2, một chu kỳ kéo dài khoảng hai tuần: tuần đầu dành cho phát triển, với nightly build được phân phối cho nhóm alpha; sang tuần thứ hai, mã nguồn được tách nhánh phát hành, chỉ nhận bản sửa lỗi nghiêm trọng, rồi chuyển sang beta test và kiểm thử hồi quy thủ công; cuối tuần và thứ Hai là giai đoạn ổn định và gửi lên app store, trước khi triển khai dần từ 1% lên 100% người dùng vào thứ Ba, thứ Tư.
Trước khi gửi duyệt, mỗi bản phát hành phải vượt qua các cổng chất lượng: mọi commit đều qua kiểm thử tự động, không còn lỗi chặn phát hành, các team liên quan đã ký duyệt, tỷ lệ crash nằm dưới ngưỡng cho phép và có đủ dữ liệu kiểm thử về mức độ sử dụng nội dung. Để giảm rủi ro, những tính năng lớn như Audiobooks trong bản 8.9.2 được lên lịch phát hành riêng và được rà soát crash kỹ lưỡng; feature flag cho phép merge mã nguồn an toàn mà chưa bật cho người dùng; còn giai đoạn triển khai 1% giúp phát hiện sự cố nghiêm trọng trước khi lan rộng. Nhờ vậy, khoảng 95% phiên bản theo kế hoạch được phát hành thành công tới toàn bộ người dùng mỗi tuần.
Components of A Coding Agent
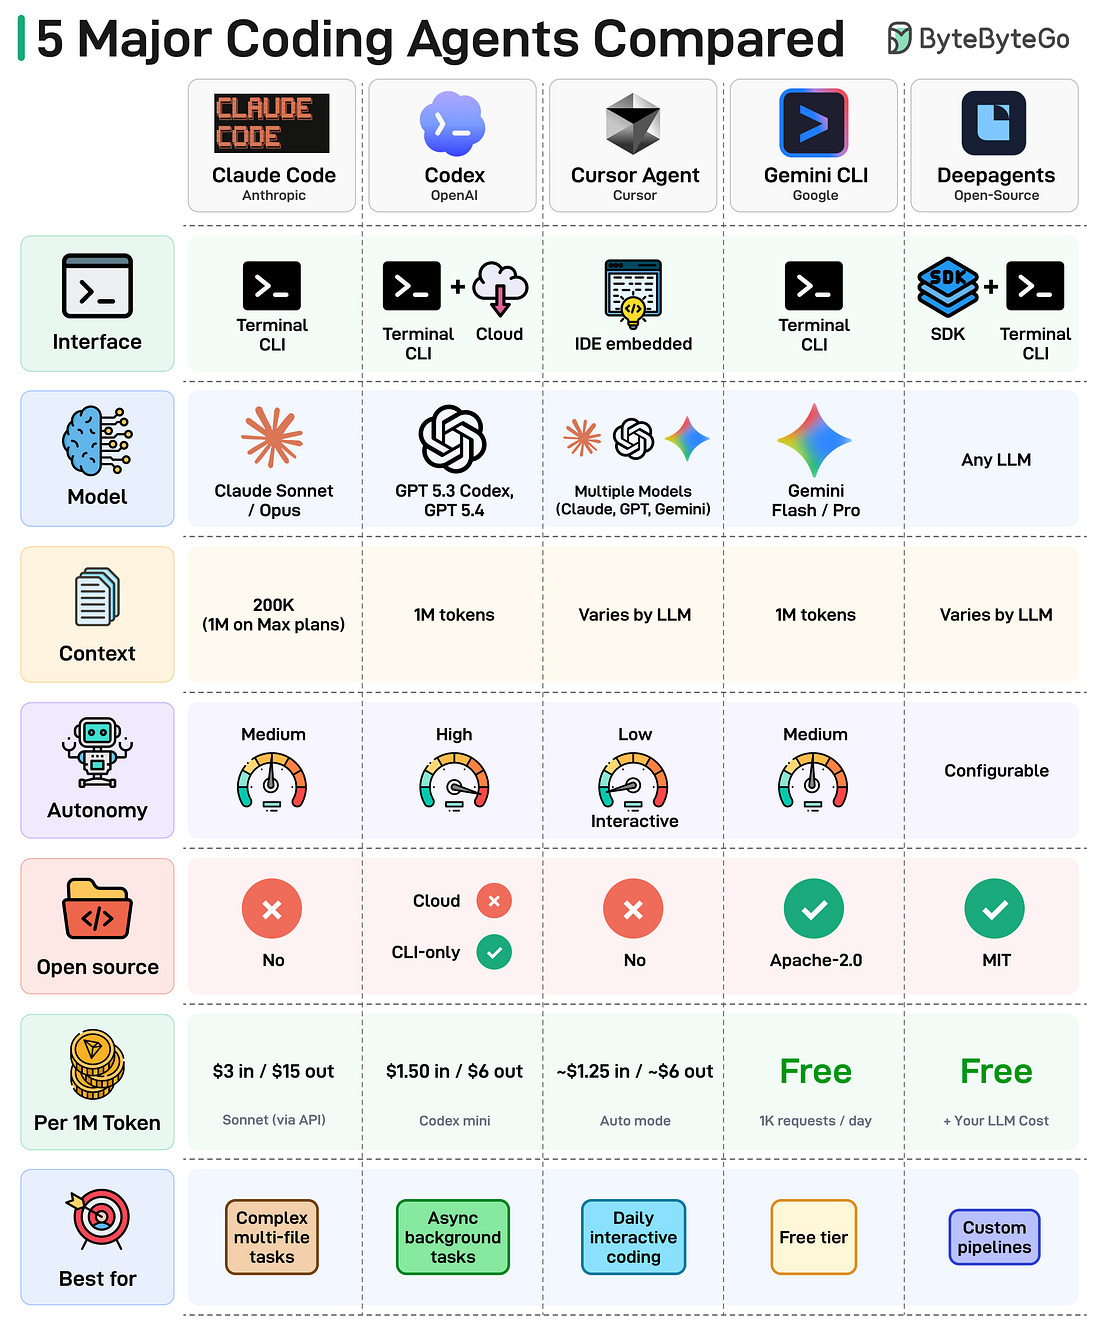
Sebastian Raschka giải thích rằng các coding agent như Claude Code hay Codex CLI thực chất là một lớp phần mềm bao quanh LLM, biến model thành công cụ lập trình thực thụ. Theo tác giả, chất lượng agent không chỉ đến từ sức mạnh của model mà phần lớn nằm ở harness — vòng điều khiển, hạ tầng runtime và cách quản lý ngữ cảnh. Một harness tốt có thể khiến cả reasoning model lẫn non-reasoning model mạnh hơn hẳn so với khi dùng trực tiếp trong giao diện chat.
Bài viết mô tả sáu thành phần cốt lõi. Thứ nhất là ngữ cảnh repo trực tiếp: thu thập cấu trúc mã nguồn, trạng thái git và tài liệu dự án trước khi xử lý yêu cầu. Thứ hai là tách prompt thành phần ổn định (tool, chỉ dẫn) và phần động để tái sử dụng cache, giảm đáng kể chi phí tính toán. Thứ ba là truy cập tool có cấu trúc: một danh sách tool được định nghĩa rõ kèm kiểm tra quyền, đáng tin cậy hơn nhiều so với để model tự gợi ý lệnh bằng văn bản. Thứ tư là thu gọn ngữ cảnh bằng cách cắt output dài, khử trùng lặp và tóm tắt transcript cũ để tránh phình context. Thứ năm là bộ nhớ phiên có cấu trúc, duy trì song song transcript đầy đủ và một working memory gọn nhẹ để session dài vẫn hiệu quả và có thể khôi phục. Cuối cùng là subagent có giới hạn, cho phép agent chính giao việc con cho agent phụ kế thừa ngữ cảnh nhưng bị ràng buộc chặt, mở đường cho xử lý song song mà không mất kiểm soát.
Say the Thing You Want
Tác giả blog Terrible Software đưa ra một lời khuyên đơn giản nhưng hay bị bỏ qua: hãy nói thẳng với manager về điều bạn muốn trong sự nghiệp. Nhiều kỹ sư đến cuối buổi 1:1, khi được hỏi “còn gì nữa không?”, lại trả lời “không, ổn cả” dù đang muốn dẫn dắt dự án mới hay chuyển team, vì sợ bị coi là tự phụ, sợ bị đánh giá là chưa sẵn sàng hoặc ngại để lộ một mong muốn có thể không đạt được. Nhưng như bài viết nhận xét, một mong muốn giữ cho riêng mình thì “không có bề mặt” nào để người khác phản hồi, xây dựng tiếp hay giúp đỡ.
Manager dù chu đáo đến đâu cũng không đọc được suy nghĩ, lại còn nhiều người khác phải lo. Khi có cơ hội làm tech lead, trong hai kỹ sư cùng năng lực, người từng nói ra mong muốn thường sẽ được chọn. Nói ra còn mở cửa cho phản hồi: manager có thể chỉ ra khoảng trống kỹ năng bạn cần bù đắp — một “tấm bản đồ” mà việc tự đánh giá không thể thay thế, vì ai cũng có điểm mù. Hơn nữa, khi nói thành lời, mục tiêu trở nên thật và thúc đẩy bạn hành động. Cách bắt đầu không cần cầu kỳ: chỉ cần hỏi thẳng về lộ trình lên senior hay điều kiện để được dẫn dắt một dự án. Và nếu chỉ việc nói ra mong muốn đã khiến bạn bị phạt, đó cũng là điều đáng biết sớm.
Agentic Coding and Microservices
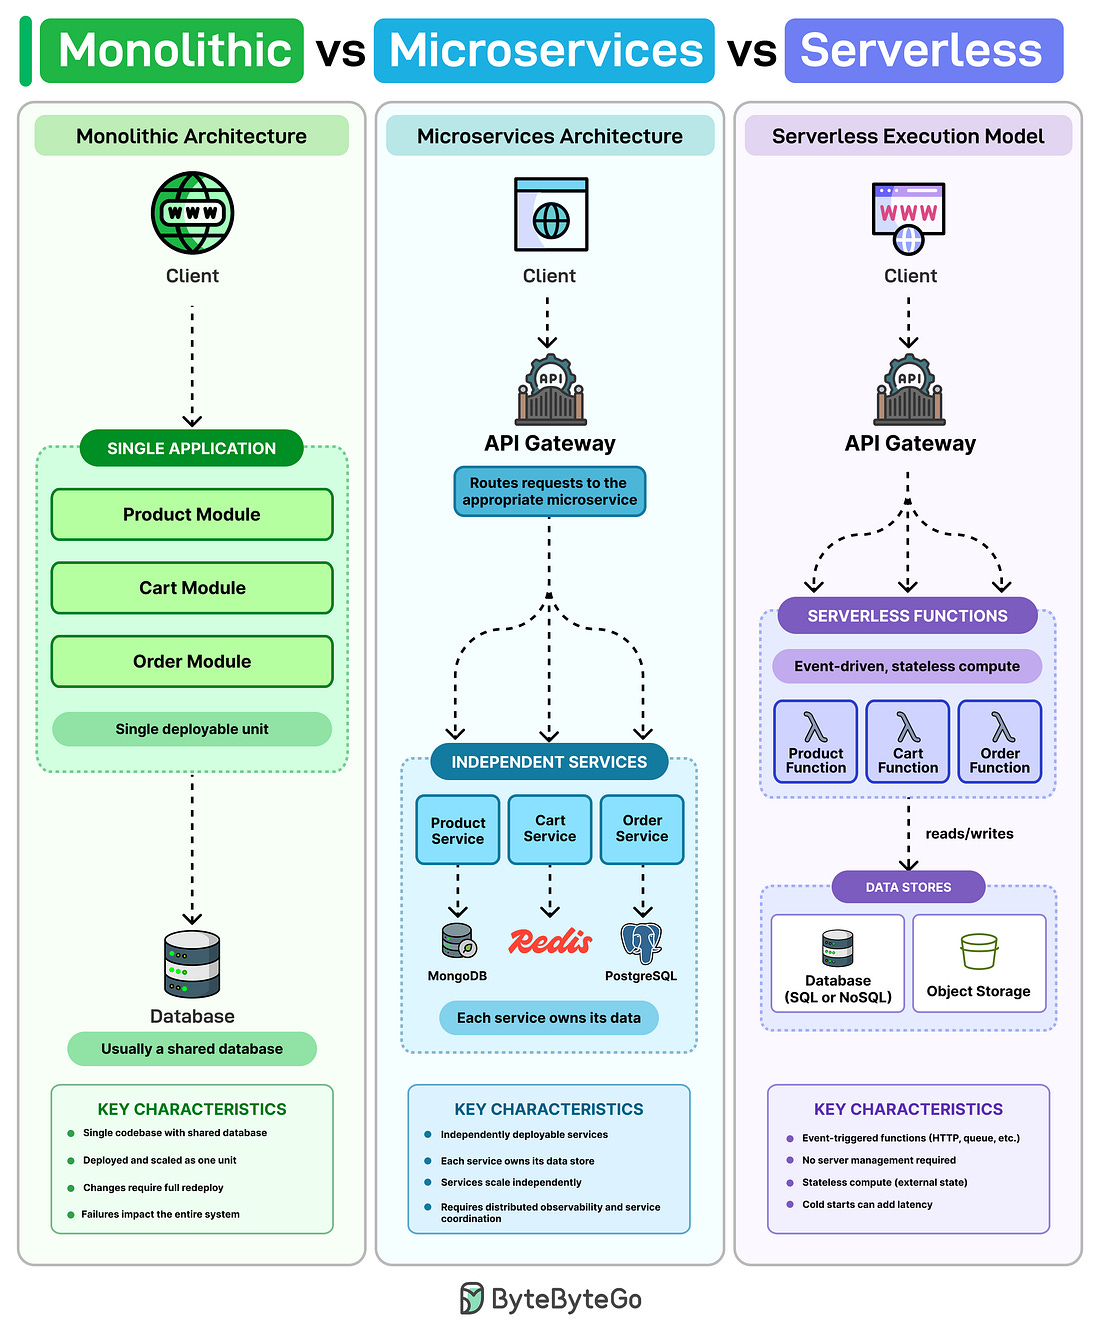
Nate Meyvis phản biện lập luận của Ben Borgers rằng AI đang đẩy chúng ta về phía microservices vì LLM làm việc tốt hơn với sự đóng gói (encapsulation) chặt chẽ. Tác giả đồng ý vế đầu, nhưng cho rằng lợi ích của encapsulation vốn chẳng mới và cũng không riêng gì LLM — người, agent hay team nào cũng làm việc tốt hơn khi ranh giới rõ ràng. Thực tế, AI lại khiến nhiều dự án của ông trở nên nguyên khối (monolith) hơn: microservices vẫn vướng bài toán kinh điển khi các service cần dùng chung dữ liệu, và phát triển cùng AI còn khiến bạn gặp các vấn đề đó sớm hơn; trong khi đó, triển khai một monolith thường nhanh hơn triển khai toàn bộ hệ microservices, rất hợp với nhịp lặp nhanh khi có AI hỗ trợ.
Điểm mấu chốt là ranh giới giữa các service không phải điều kiện cần, cũng chẳng phải điều kiện đủ cho encapsulation: microservices vẫn có thể phụ thuộc chéo một cách tinh vi, còn monolith vẫn giữ được ranh giới chặt nếu có kỷ luật. Theo trải nghiệm của tác giả, LLM thích thêm chức năng vào service sẵn có hơn là đề xuất service mới, và một file AGENTS.md viết rõ ràng, kèm nhắc nhở thường xuyên, thường đủ để AI xây dựng các hệ thống con được đóng gói tốt mà không phải gánh chi phí vận hành hệ phân tán. Vì vậy, trong thế giới ưu tiên AI, một monolith có tài liệu tốt thường là lựa chọn thực dụng hơn.
Garbage Collection: From First Principles to Modern Collectors in Java, Go and Python
Bài viết đi từ nền tảng lý thuyết của garbage collection (GC) — khởi đầu từ bài báo năm 1960 của McCarthy, nơi mark-and-sweep lần đầu được mô tả — đến cách Java, Go và Python hiện thực GC ngày nay. Theo phân loại trong khảo sát năm 1992 của Wilson, có ba trường phái chính: mark-and-sweep đơn giản nhưng gây phân mảnh heap; copying (semi-space) chép các object còn sống sang nửa heap còn lại, cấp phát nhanh bằng cách dịch con trỏ nhưng luôn bỏ trống một nửa bộ nhớ; và reference counting giải phóng ngay khi bộ đếm về 0 nhưng gặp khó với tham chiếu vòng. Giả thuyết thế hệ — “hầu hết object chết trẻ” — là cơ sở để các collector hiện đại tập trung thu gom vùng young generation, giảm mạnh khối lượng công việc mỗi chu kỳ.
Go dùng concurrent mark-and-sweep với tri-color marking và hybrid write barrier, nhắm tới thời gian dừng dưới 1ms và không nén (compaction) heap. Java G1GC chia heap thành các region 1–32MB và dùng SATB để đánh dấu song song; ZGC mã hóa metadata vào các bit chưa dùng của con trỏ (colored pointer) và dùng load barrier để cập nhật con trỏ lười, đạt thời gian dừng dưới một mili giây trên heap hàng trăm GB. CPython chủ yếu dựa vào reference counting được GIL bảo vệ, bổ sung bộ phát hiện chu trình chạy theo ba thế hệ 0, 1, 2. Về đánh đổi, tracing thắng thế ở server runtime vì chi phí trên mỗi thao tác ghi của refcount cộng dồn quá nhanh; nén heap cho phép cấp phát kiểu bump-pointer nhưng phải cập nhật con trỏ, còn không nén thì tránh được việc đó nhưng chấp nhận cấp phát chậm hơn.
I told Claude Code to build me an executive assistant
Obie Fernandez, CTO tại ZAR, kể cách ông biến Claude Code thành trợ lý điều hành cá nhân chỉ bằng một prompt: yêu cầu Claude tự thiết kế một hệ thống file markdown giúp ông làm CTO ở đẳng cấp thế giới. Ông không tự tạo thư mục hay template nào mà để Claude tự tổ chức. Sau khoảng ba tuần, hệ thống đã xử lý 82 biên bản cuộc họp, 47 cuộc họp chỉ riêng trong tháng, theo dõi 23 thành viên với 264 dòng ngữ cảnh chi tiết, và tích lũy 11.579 dòng tri thức tổ chức — trong khi ông vẫn quản lý 10 kỹ sư, viết mã và làm việc ở cấp lãnh đạo.
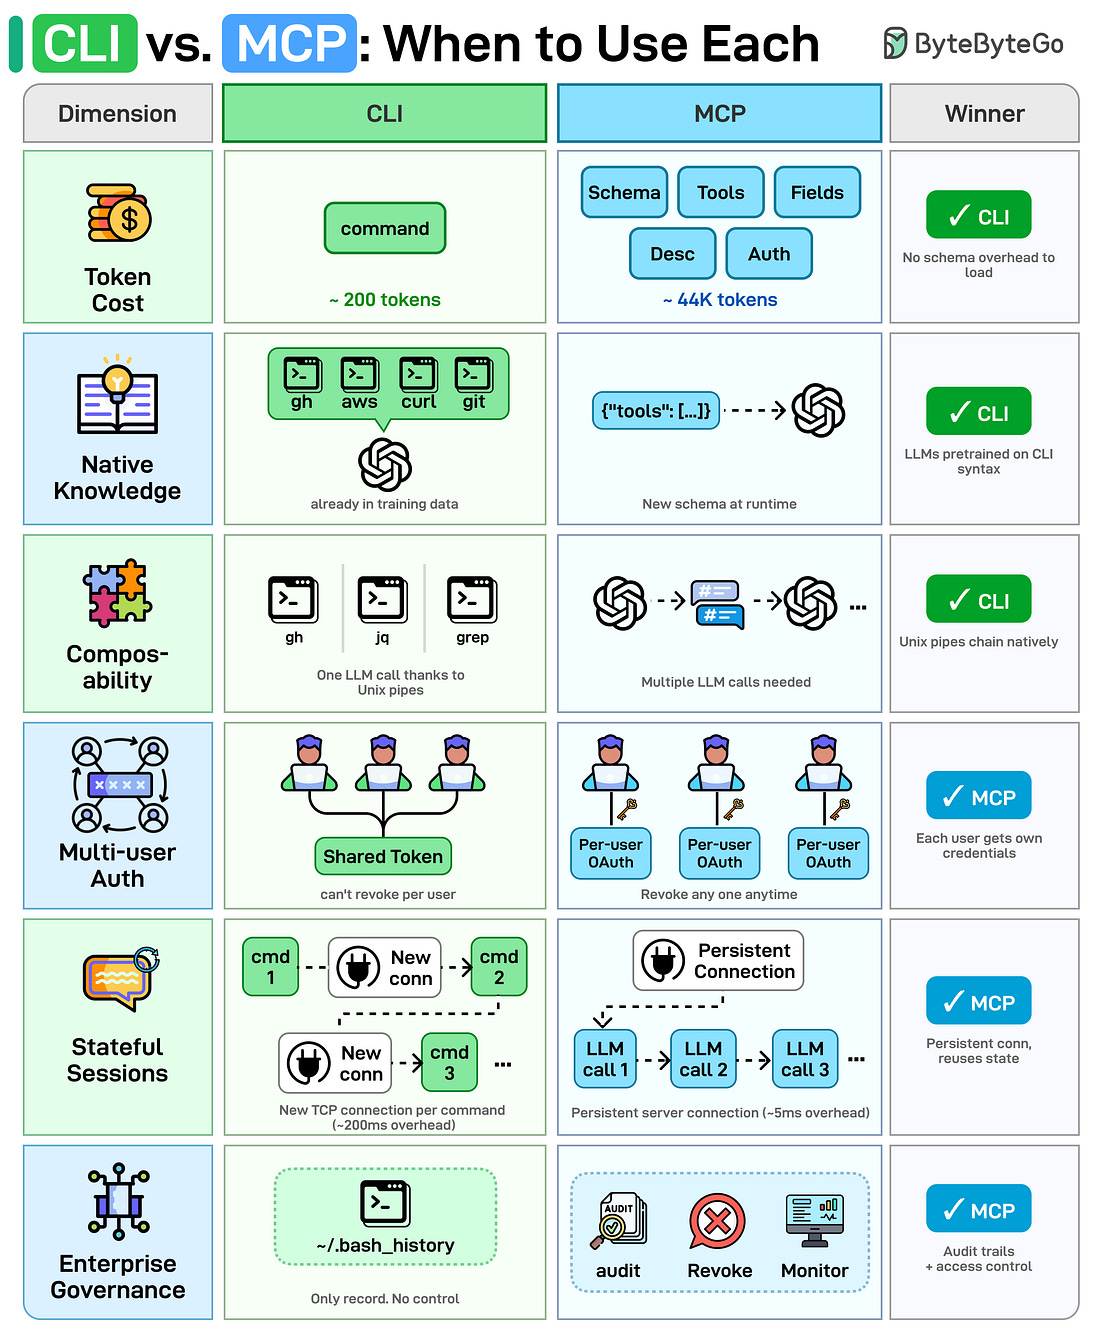
Điểm mấu chốt là ông “không bao giờ nghĩ về hệ thống”, chỉ trò chuyện tự nhiên với Claude, thường bằng giọng nói qua Wispr Flow, và luôn mở ít nhất một session Claude Code; khi có nhiều việc song song, ông mở thêm session để chuẩn bị nhiều cuộc họp cùng lúc. Các lệnh quen thuộc gồm “morning sync” để tổng hợp lịch và việc ưu tiên, “prep for 1:1 with Daniel” để đọc lại lịch sử và gợi ý chủ đề, hay “log decision about X” để ghi lại quyết định có cấu trúc; sau mỗi cuộc họp, ông chỉ cần dán transcript để Claude tự tạo ghi chú và danh sách việc cần làm. Tích hợp Rube/MCP với Calendar, Slack, Twitter, Linear là yếu tố sống còn, giúp Claude hành động trực tiếp mà không phải chuyển ngữ cảnh. Thông điệp của Obie: mọi knowledge worker rồi sẽ cần một hệ thống tương tự, và ai chần chừ sẽ bị tụt lại.
Bonus
Images:
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.