Mời bạn thưởng thức Newsletter #118.
Telling the story right: efficient logging in Go
Tiếp nối bài viết về lỗi trong Go, Robin Siep bàn về logging: log tốt phải đủ ngữ cảnh để gỡ lỗi production nhưng vẫn dễ đọc khi phát triển cục bộ. Có ba nhóm cần ghi log: lỗi, gần như luôn ở mức ERROR kèm stack trace và điều kiện xảy ra; sự kiện nghiệp vụ và chuyển trạng thái quan trọng, thường ở mức INFO, ghi rõ ai thực hiện; và giao tiếp với cơ sở dữ liệu, dịch vụ bên thứ ba hay ứng dụng khách, phần quá nhiễu có thể hạ xuống DEBUG. Ba sai lầm hay gặp là ghi secret, thông tin đăng nhập hay dữ liệu cá nhân vào log, chạy production sai log level, và cắt giảm log quá sớm, vì ghi quá ít thường gây hại hơn.
Structured log là bắt buộc trên production vì dễ lọc và truy vấn, còn log văn bản có màu dễ theo dõi khi làm cục bộ. Tác giả khuyên giữ cả log văn bản trên production: khi đường ống thu thập log hỏng, đó là thứ còn lại để xoay xở và sửa chính đường ống ấy. Phần triển khai dùng slog với hai handler tự viết: một handler chuyển bản ghi sang định dạng CLEF để gửi tới Seq và tách stack trace vào trường riêng; một handler văn bản tô màu, hiển thị thuộc tính dễ đọc. Nếu gửi sang Seq thất bại, lỗi của đường ống và bản ghi gốc vẫn được ghi qua handler văn bản. Cách làm này dùng được cho cả zap, và cho thấy log chỉ có giá trị khi giữ được ngữ cảnh ngay cả lúc hệ thống quan sát gặp sự cố.
On CPU Physics and CPU Cycles
Bài viết là bản nháp một phần chương sách về lập trình C++ hiệu quả trên CPU 64-bit hiện đại, với luận điểm chính: hiệu năng không chỉ phụ thuộc thuật toán mà còn bị chi phối bởi vật lý phần cứng. Tín hiệu điện phải đi càng xa thì truy cập càng chậm, chủ yếu do điện dung ký sinh tăng theo chiều dài đường dẫn. Đó là lý do phép tính trên thanh ghi và ALU chỉ tốn vài chu kỳ, L1 cache cũng chỉ vài chu kỳ, L2 và L3 đắt dần, còn một lần truy cập RAM chính có thể mất tới hàng trăm chu kỳ CPU. Đi xa hơn nữa, từ bo mạch chủ tới SSD, HDD và mạng, độ trễ tăng thêm nhiều bậc độ lớn, nên tính cục bộ của dữ liệu trong cache có ảnh hưởng thực tế rất lớn.
Để che bớt độ trễ, CPU hiện đại dùng pipeline, thực thi superscalar và dự đoán nhánh, cho phép chạy tiếp trước khi biết kết quả của một phép rẽ nhánh. Tuy vậy, mỗi lần đoán sai vẫn tốn khoảng vài chục chu kỳ; các gợi ý [[likely]]/[[unlikely]] chỉ nên dùng khi nhánh thật sự rõ ràng, chẳng hạn đường xử lý lỗi. Với bộ nhớ trong C/C++, stack thường nằm sẵn trong cache, vùng static/global ở mức trung bình, còn heap nên được coi là “lạnh”, trừ khi dữ liệu nằm gần nhau hoặc được duyệt tuần tự qua cấu trúc liên tục như vector. Vì vậy vector thường thân thiện với cache và TLB hơn hẳn các cấu trúc dựa trên node như danh sách liên kết hay cây. Hãy nhìn hiệu năng như một chuỗi chi phí vật lý.
The Log Is the Agent
Ishaan Sehgal đưa ra một định nghĩa gọn cho AI agent: agent không phải model, runtime, vòng lặp đang chạy hay bộ công cụ, mà là log bền vững ghi lại mọi thứ nó đã thấy và đã làm. Tác giả mượn hình ảnh nhân vật chơi hàng trăm giờ trong Skyrim hay Elden Ring: thứ làm nên nhân vật không phải game engine, máy chơi game hay tay cầm, mà là file lưu game. Với agent, log là chuỗi sự kiện chỉ ghi thêm gồm đầu vào của người dùng, đầu ra của model, lời gọi công cụ và kết quả, kèm tham chiếu tới system prompt và skill. Chỉ riêng log đã đủ để một tiến trình mới dựng lại trạng thái và chạy tiếp.
Hệ quả kiến trúc là log phải là thành phần trung tâm chứ không phải sản phẩm phụ để gỡ lỗi. Mọi thao tác đều đọc log, ghi thêm vào log hoặc hiển thị một góc nhìn của log, giống cách cơ sở dữ liệu coi bảng, chỉ mục và cache là các phép chiếu trên log thay đổi. Vòng lặp chạy trên log vì thế có tính idempotent và chịu lỗi tốt: worker chết thì worker khác nhận phiên và làm tiếp; muốn thử model hay chiến lược khác thì rẽ nhánh từ cùng một lịch sử. Compaction hay bản tóm tắt giúp vừa cửa sổ ngữ cảnh nhưng bản chất là mất thông tin, nên không được thay thế log gốc làm nguồn sự thật. Nó cũng lộ ra một kiểu phụ thuộc nhà cung cấp mới: phụ thuộc vào lịch sử vận hành của agent. Khả năng xem, xuất và truy vấn log quyết định ai thật sự sở hữu agent.
Software Is Not A Single-Player Game
David Poll phản hồi quan điểm cho rằng mọi phán đoán quan trọng nên diễn ra trước code review, ở giai đoạn PRD hay design doc. Quan điểm đó có gốc rễ hợp lý: viết mã từng là bước đắt nhất, nên ngành dựng cả hạ tầng như PRD, design doc và RFC để giảm cái giá của việc làm sai. Nhưng cách nhìn tuyến tính ấy bỏ lỡ bản chất của phát triển phần mềm: đây không phải trò chơi một người, mà là nơi nhiều người cùng rèn gu kỹ thuật, mô hình tư duy chung và phán đoán sản phẩm theo thời gian. Code review không chỉ để bắt lỗi, mà là một trong những nơi chính quá trình đó diễn ra.
Khi AI làm chi phí viết mã giảm mạnh, những tài liệu vốn chỉ là vật thay thế cho mã đang nhường chỗ cho thay đổi chạy được. Prototype hay pull request giờ đủ rẻ để trở thành nơi tranh luận tốt hơn, và điều đó khiến review càng trở nên trung tâm: đội ngũ nhìn vào thay đổi thật, hỏi nó tác động thế nào tới hệ thống và người dùng, rồi quyết định có đưa vào sản phẩm hay không. Một pull request bị đóng không còn là thất bại mà có thể là cách rẻ nhất để biết một hướng đi không phù hợp. Tuy vậy, tác giả cảnh báo xu hướng “cứ phát hành rồi rollback”: mã có thể hoàn tác, còn niềm tin và ấn tượng của người dùng về sản phẩm thì không. Một số quyết định vẫn phải chốt trước khi viết mã, như kiến trúc cấp tổ chức, bảo mật, tuân thủ hay cam kết với khách hàng, nhưng phạm vi đó đang thu hẹp dần.
Cleaning up after AI rockstar developers
Jesse Skinner dùng hình ảnh “rockstar developer” để nói về một rủi ro quen thuộc: một người rất giỏi, rất nhanh, mê công nghệ mới, có thể một mình viết lại phần lõi hệ thống, nhưng để lại mã nguồn mà cả đội khó hiểu và khó bảo trì. Khi người đó rời đi, những người ở lại phải trả giá thật: mất nhiều thời gian chỉ để chạy được dự án, lần theo luồng dữ liệu rối rắm, học thêm ngôn ngữ hay thư viện lạ, và thuyết phục tổ chức rằng hệ thống cần được cứu thay vì tiếp tục tin vào hào quang cũ.
Điểm chính của bài viết là AI có thể khuếch đại đúng vấn đề này. Mỗi phiên trò chuyện với LLM giống như thêm một “rockstar” mới vào codebase: sinh mã cực nhanh, không nhớ ngữ cảnh dài hạn, thích áp dụng các best practice chung chung dù bài toán không cần, và không chịu trách nhiệm về việc hệ thống có còn dễ hiểu với cả đội hay không. Khi hàng loạt tính năng và bản sửa lỗi được tạo ra qua nhiều phiên khác nhau, codebase dễ biến thành tập hợp của hàng trăm phong cách thiết kế rời rạc, còn kiến trúc thì phình ra vượt xa độ phức tạp thật của bài toán. Tác giả khuyên dùng LLM như công cụ hỗ trợ dưới sự dẫn dắt kỹ thuật của con người: làm từng thay đổi nhỏ, xem xét kỹ từng thay đổi, giữ quyền kiểm soát kiến trúc, liên tục đơn giản hóa, và sẵn sàng tự viết mã khi đó là cách tốt hơn để giữ chất lượng.
A new era for software testing
Antirez nhận định lập trình tự động bằng AI giúp tăng tốc nhưng phải đánh đổi chất lượng cấu trúc của mã, còn với QA, LLM mở ra cách tự động hóa mạnh hơn mà không hy sinh chất lượng. Bộ kiểm thử truyền thống gồm unit test và integration test vẫn cần thiết, nhưng phủ hết mọi dòng mã không có nghĩa là phủ hết mọi trạng thái. Kiểm thử tích hợp vốn khó vì vấn đề thời gian, thiết lập phức tạp và đầu ra chỉ đánh giá được bằng mắt, nên nhiều bài kiểm thử thủ công bị bỏ qua.
Đề xuất của tác giả là viết một file Markdown yêu cầu AI agent đóng vai kỹ sư QA, thực hiện loạt kiểm thử thủ công trên bản phát hành mới. Agent bắt đầu bằng việc đọc các commit mới so với bản đã phát hành, xác định vùng có thể bị ảnh hưởng, rồi tập trung săn các lỗi hồi quy cụ thể. Với DwarfStar, một inference engine cho LLM mã nguồn mở, agent kiểm tra suy luận phân tán giữa hai máy MacBook với mọi file GGUF có sẵn, đồng thời phát hiện suy giảm tốc độ mà không cần biết trước tốc độ cũ, vì đó là mục tiêu thay đổi theo từng bản. Với Redis Arrays, agent tự xây một ứng dụng lớn, dựng môi trường có replication và persistence, mô phỏng nhiều ngày sử dụng với nhiều người dùng để tìm hành vi bất thường. Agent còn có thể chỉ ra tính năng gây bất ngờ, thiếu tài liệu hay cẩu thả. Antirez tin rằng QA tự động có thể nâng chuẩn chất lượng mỗi bản phát hành, phần nào bù lại chất lượng mã thấp hơn khi viết nhanh bằng AI.
Nobody Pushed Back: Why Engineers Stay Silent Until It’s Too Late
Bài viết lập luận rằng nhiều thảm họa kiến trúc xảy ra không phải vì kỹ sư không biết vấn đề, mà vì họ biết nhưng không thấy an toàn để lên tiếng. Trong phòng họp, một quyết định kỹ thuật có thể được thông qua dưới nhãn “alignment” dù nhiều người không thật sự đồng tình; vài tháng sau hệ thống sụp đổ, ai cũng nói mình đã thấy trước. Đây là một mẫu lặp lại: rủi ro kỹ thuật đã rõ, những người gần hệ thống nhất nhìn thấy nó, nhưng cái giá xã hội và nghề nghiệp của việc phản biện cao hơn cái giá của im lặng. Các ví dụ Nokia, TSB, Boeing và Microsoft cho thấy thông tin xấu hiếm khi thiếu, chỉ là không đến được nơi ra quyết định. Nokia có người hiểu Symbian không hợp với kỷ nguyên màn hình cảm ứng; TSB có những phản đối kỹ thuật trước đợt chuyển đổi hệ thống lớn; Boeing có kỹ sư biết rủi ro của MCAS; Microsoft từng có tín hiệu rằng hướng đi của Windows Phone đang tự dồn vào ngõ cụt. Vấn đề không nằm ở sự thiếu can đảm, mà ở hệ thống: phản biện bị gắn nhãn tiêu cực, ý kiến của người có chức vụ cao nhất (HiPPO) luôn thắng, còn các chỉ số “xanh” được dùng để khép lại tranh luận, biến quyết định kỹ thuật thành quyết định xã hội. Phản biện hiệu quả không phải là nói “sai rồi”, mà là làm cho chi phí và rủi ro trở nên cụ thể bằng những câu hỏi như quyết định này sẽ tốn gì sau 18 tháng, rủi ro được kiểm thử ra sao, và kế hoạch rollback là gì nếu mọi thứ đổ vỡ.
Loop Engineering
Addy Osmani mô tả “loop engineering” là bước tiếp theo của prompt engineering: thay vì tự tay nhắc agent từng lượt, kỹ sư thiết kế một vòng lặp tự tìm việc, giao việc, kiểm tra kết quả và quyết định bước tiếp theo. Vòng lặp giống một mục tiêu đệ quy: đặt ra mục đích, rồi AI lặp lại cho tới khi hoàn thành. Theo tác giả, hình mẫu này đã thành hiện thực vì cả Codex lẫn Claude Code đều có đủ các mảnh ghép cần thiết, nên thay vì tranh cãi chọn công cụ nào, hãy thiết kế một vòng lặp chạy được trên cả hai.
Một vòng lặp gồm năm khối. Automation chạy theo lịch để phân loại issue, tóm tắt lỗi CI hay săn lỗi mới. Worktree cho phép nhiều agent làm song song mà không ghi đè file của nhau. Skill đóng gói kiến thức dự án để không phải giải thích lại mỗi phiên. Connector, thường xây trên MCP, cho agent chạm tới issue tracker, cơ sở dữ liệu, Slack hay API staging. Sub-agent tách người làm khỏi người kiểm tra, vì agent viết mã thường quá dễ dãi khi tự chấm bài. Ngoài ra cần một vùng nhớ bền vững nằm ngoài ngữ cảnh như file Markdown hay bảng Linear, bởi model có thể quên giữa các lần chạy còn repo thì không. Dù vậy, Addy nhấn mạnh vòng lặp không xóa bỏ vai trò kỹ sư: một vòng lặp chạy không giám sát cũng là vòng lặp mắc lỗi không giám sát. Nếu không xem xét và hiểu mã được tạo ra, vòng lặp chỉ khiến “nợ hiểu biết” tích tụ nhanh hơn; vòng lặp tốt giúp tăng tốc trong khi kỹ sư vẫn nắm sâu hệ thống.
Bonus
Images:
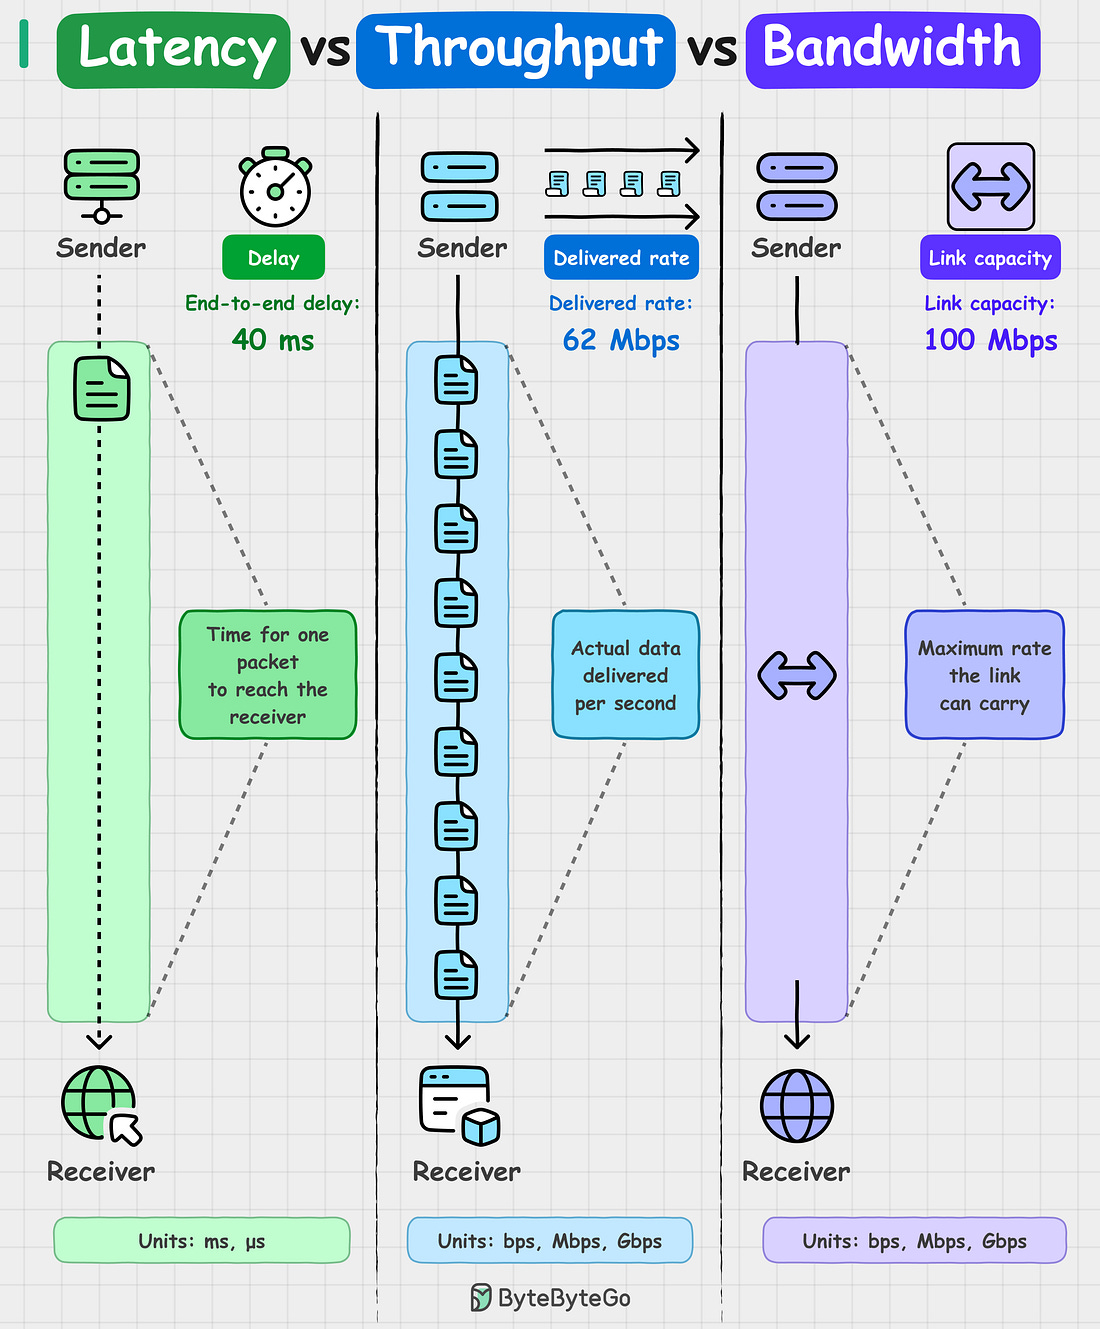

Videos: CPU, GPU và TPU khác nhau thế nào?
Video giải thích sự khác nhau giữa CPU, GPU và TPU: CPU linh hoạt cho các tác vụ tổng quát, GPU mạnh ở xử lý song song, còn TPU là phần cứng chuyên dụng cho khối lượng công việc học máy. Nội dung ngắn gọn, giúp chọn đúng loại phần cứng theo độ trễ, thông lượng và chi phí.
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.